BigQuery dobio AI.AGG: semantički sažetak miliona redova kroz jedan SQL upit
Googleova preview funkcija deli velike skupove u grupe, paralelno pravi međusažetke i rekurzivno ih spaja. Trošak tokena i ograničenja ostaju važni.
Jedan SQL upit za semantički pregled velikih skupova
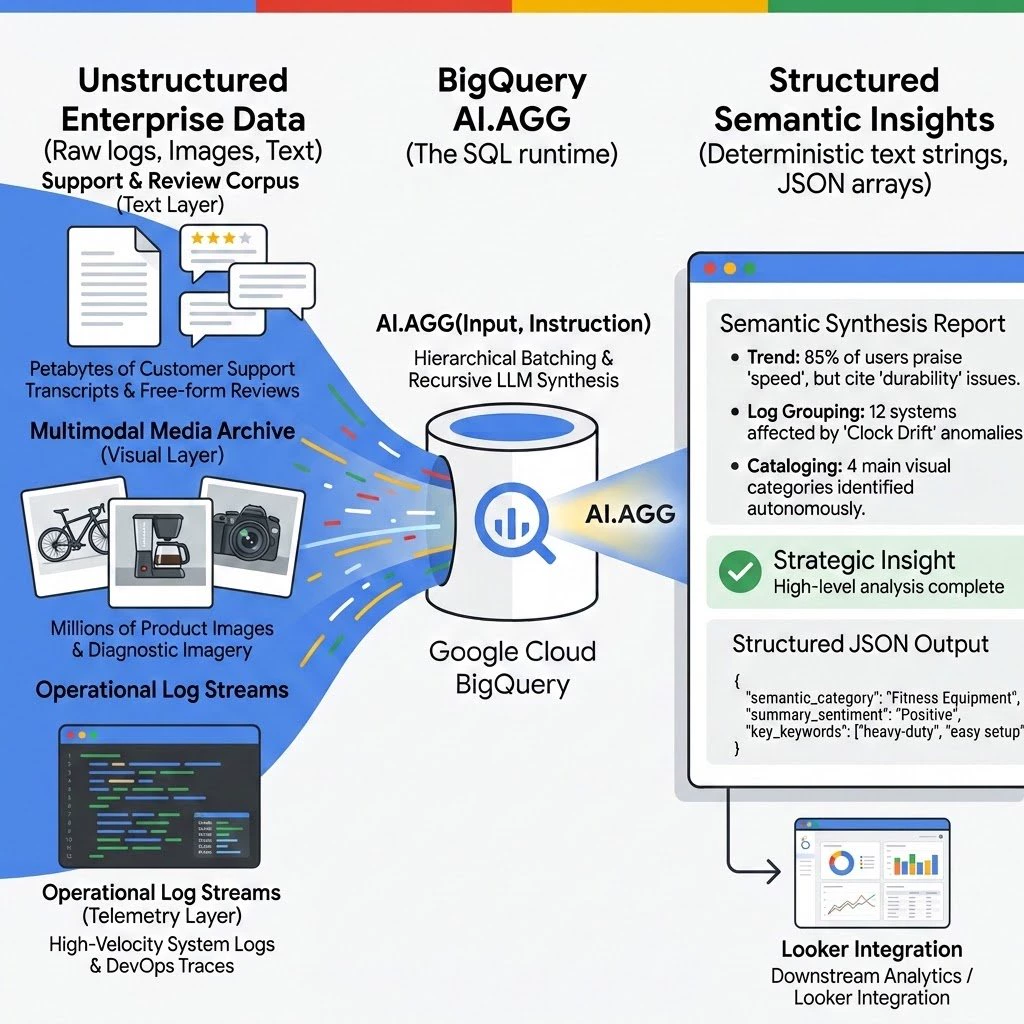
Google Cloud je 5. novembra predstavio detalje funkcije AI.AGG u BigQueryju, namenjene semantičkom objedinjavanju velikih količina teksta i multimodalnih podataka. Funkcija je još u preview režimu, pa je ne treba predstavljati kao završenu i nepromenljivu uslugu. Za razliku od uobičajenog SUM ili COUNT izračunavanja, korisnik prirodnim jezikom opisuje šta želi da izvuče iz logova, transkripata podrške, opisa proizvoda, slika ili dijagnostičkih izveštaja.
Problem koji Google pokušava da reši jeste ograničen kontekstni prozor velikog jezičkog modela. Milioni redova ne mogu jednostavno da se ubace u jedan prompt, jer bi sadržaj bio skraćen ili bi izvršavanje stalo. Timovi su zato ranije pravili spoljne map-reduce tokove, ručno delili podatke i spajali delimične rezultate. AI.AGG tu koordinaciju premešta u BigQuery GoogleSQL i omogućava da se ista instrukcija pokrene kroz jedan upit.
Paralelne grupe i rekurzivno spajanje
BigQuery prvo proverava pojedinačne redove i formira grupe koje mogu da stanu u kontekst izabranog Gemini modela. Ista instrukcija zatim se primenjuje paralelno na svaku grupu preko Vertex AI-ja, stvarajući međurezultate. Sistem ih ponovo grupiše i šalje modelu sve dok ne dobije jedan završni tekst za svaku SQL GROUP BY grupu. Google ovu arhitekturu opisuje kao višestepeno, rekurzivno smanjivanje, a ne kao jedno veliko pozivanje modela.
Funkcija podržava i slike preko BigQuery Object Tables i OBJ.GET_ACCESS_URL, bez obaveznog prekodiranja ili seljenja datoteka iz Cloud Storage-a. To omogućava, na primer, zajednički pregled slika proizvoda i njihovih tekstualnih opisa. Ipak, rezultat i dalje generiše model: SQL izvršavanje ne pretvara procenu u determinističku činjenicu, pa važni zaključci moraju da prođu dodatnu proveru.
Logovi, korisnička podrška i automatsko označavanje
Google kao jedan primer navodi grupisanje velikog broja sistemskih logova po komponenti i pravljenje čitljivog dijagnostičkog sažetka. Drugi primer je arhiva korisničke podrške bez dobre kategorizacije: AI.AGG može da predloži listu tema u JSON formatu, a te oznake zatim mogu da se proslede funkciji AI.CLASSIFY. Takav tok smanjuje potrebu za posebnim Python skriptama, ali ne uklanja odgovornost inženjera da proveri kategorije i spreči model da izmisli uzrok problema.
Google posebno upozorava na pravilo NULL vrednosti. Kada se više kolona prosledi kroz STRUCT, jedna NULL vrednost može učiniti ceo red nevažećim i tiho ga izostaviti iz obrade. Preporuka je da se nullable polja eksplicitno obrade funkcijom IFNULL. Bez te kontrole završni sažetak može izgledati uverljivo, a da deo izvornog skupa uopšte nije učestvovao u analizi.
Trošak tokena i granice preview verzije
Rekurzivna obrada znači da ukupan broj tokena poslatih Geminiju može biti veći od broja tokena u početnom skupu. Google zato preporučuje WHERE i LIMIT prefiltriranje, AI.COUNT_TOKENS za procenu troška i keširanje konteksta kod velikih statičnih skupova. Kompanija navodi podršku za VPC Service Controls, ali to ne menja potrebu da organizacija zasebno podesi pristup podacima, reviziju i dozvole.
Preview verzija ima jasne operativne granice: izlaz po grupi ograničen je na 10.000 tokena, pojedinačni red ne sme da pređe 10 MiB, a za multimodalne nizove Google preporučuje manje od deset slika po redu. Za stabilniji rad preporučuju najviše 20 miliona redova i 1.000 izlaznih grupa po upitu. To su granice i preporuke proizvođača, ne dokaz da će svaki takav upit biti brz, jeftin ili tačan.
Za korisnike je najvažnije da AI.AGG posmatraju kao alat za pronalaženje obrazaca i pripremu sažetaka, a ne kao zamenu za klasične provere. Posebno u finansijskim, zdravstvenim i bezbednosnim analizama, rezultat modela treba povezati sa konkretnim redovima i potvrditi pre odluke.
Izvori
Podeli vest
Pošaljite ovu vest prijateljima. Link prikazuje naslov i fotografiju članka.
Komentari
Prikaz odobrenih komentara je dostupan. Slanje novih komentara biće uključeno kada se završe zaštita od zloupotreba i urednička moderacija.
Srodne vesti
 Google pretvara Gemini u interaktivnu učionicu: od atoma do svemira kroz vođeno istraživanjetehnologija
 Google predaje tri projekta CNCF-u: otvorena infrastruktura za bezbednije AI agentetehnologija
 Google širi Agentic Data Cloud: novi sloj za podatke, kontekst i AI agentetehnologija
 Agile Deliberation: Google testirao AI koji ljudima pokazuje granične slučajevenauka
Učitavanje komentara...